Qu'est-ce qu'un système multi-agents, vraiment pour ops
Résumé
Un système multi-agents est un groupe d'agents IA qui partagent un objectif : chaque spécialiste obtient son propre rôle, ses outils et son contexte, et un agent lead ou un ordre de main à main fixe les coordonne. Il surpasse un agent unique sur le travail qui se divise proprement, comme la recherche ou la préparation de comptes, et échoue sur les tâches étroitement couplées. Attends un coût de tokens plus élevé et une latence plus grande, donc commence avec deux agents.
Qu'est-ce qu'un système multi-agents ? C'est un ensemble d'agents IA qui se partagent un travail, chacun avec son rôle, ses outils et sa fenêtre de contexte, coordonnés par un agent lead ou un ordre de main à main fixe. Si tu utilises déjà un agent unique et que tu heurtes constamment ses limites, c'est la prochaine architecture à comprendre. Ci-dessous : comment elle fonctionne dans une stack ops, et quand ça coûte plus cher qu'il n'y paraît.
Briefing 30 secondes : un agent fait tout en un seul contexte long. Un système multi-agents donne chaque étape à un spécialiste et ajoute un coordinateur. Tu gagnes du travail parallèle et des outputs plus propres. Tu paies en tokens, latence et temps de debug.
Qu'est-ce qu'un système multi-agents, en termes ops concrets ?
Imagine comment ton équipe gère une deal review. Une personne tire les données du compte. Une autre contrôle l'adéquation avec ton profil client idéal (ICP). Une troisième rédige le suivi. Un lead lit les trois outputs et décide ce qui sort.
Un système multi-agents reproduit cette forme en logiciel. Chaque agent est un appel de modèle avec une instruction précise, ses propres outils et sa propre mémoire de travail. Un coordinateur divise la tâche, envoie les morceaux et fusionne les résultats.
Considère un cas concret. Un lead customer success veut un résumé santé hebdomadaire pour 40 comptes. Un agent lisant 40 historiques support, 40 exports d'usage et 40 notes de renouvellement perdra le fil vers le compte 15. Quarante petits travailleurs, chacun lisant un compte, puis un lead classant les résultats, ne le perdront pas. C'est l'idée centrale : casser un travail large en petits travaux, puis réassembler.
Deux traits comptent. D'abord, chaque agent ne retient que ce dont il a besoin, donc son contexte reste petit et concentré. Deuxièmement, les agents échangent des outputs structurés, pas du chat libre. Oublie l'un ou l'autre et tu as un fil de groupe bruyant, pas un système.
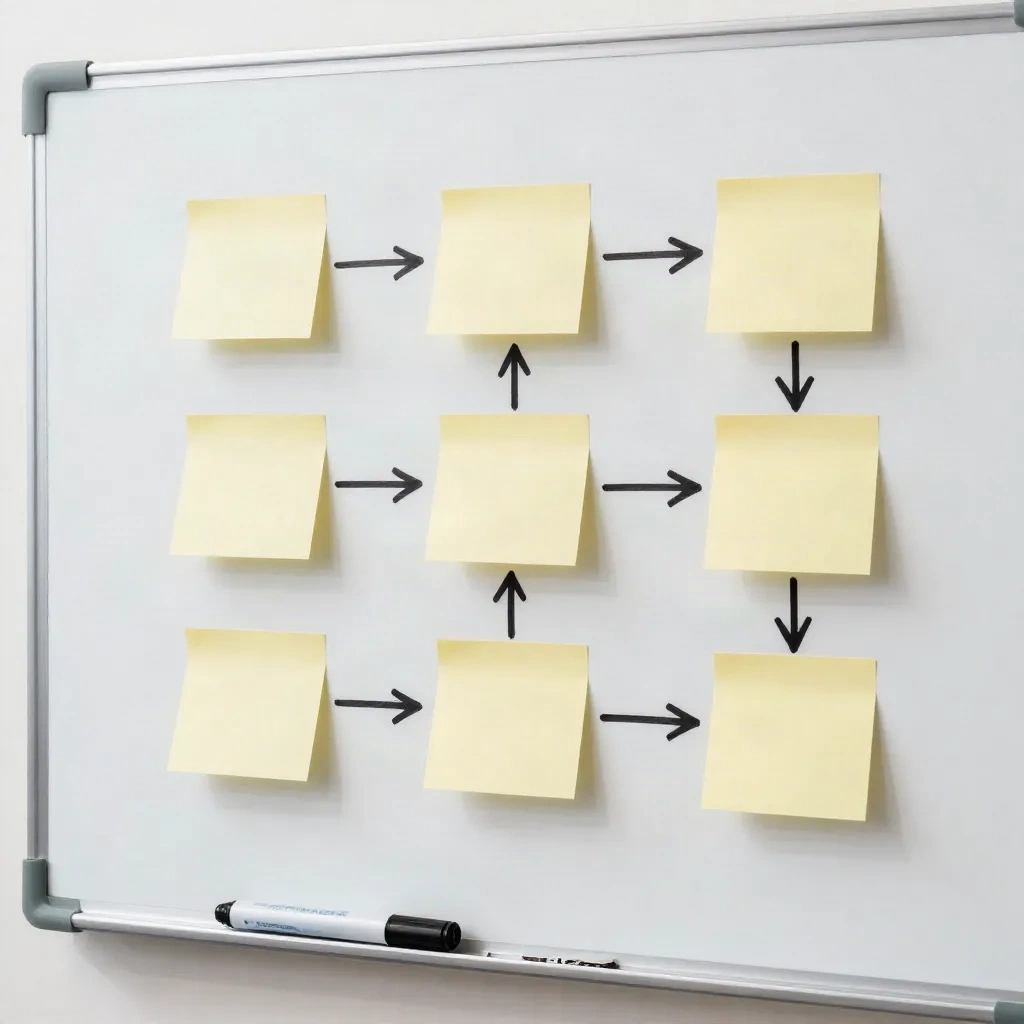
Comment ça diffère d'un agent unique ou d'un chatbot ?
Un chatbot répond à une requête. Un agent unique poursuit un objectif sur plusieurs étapes, appelant des outils en cours de route. On a couvert cet écart dans notre breakdown agent vs chatbot.
Un système multi-agents ajoute une troisième couche : plusieurs agents, chacun possédant une tranche de l'objectif. La différence surgit en trois endroits.
Contexte. Un agent unique traîne chaque résultat d'outil dans une fenêtre. Les spécialistes ne voient chacun que leur tranche.
Parallélisme. Un agent fonctionne en séquence. Un lead peut lancer cinq travailleurs à la fois.
Mode de défaillance. Un agent échoue en bloc. Dans un système, un travailleur échoue et le lead peut réessayer juste cette partie.
Il y a aussi un avantage de gouvernance que les équipes ops ont tendance à sous-estimer. Parce que chaque travailleur a un rôle étroit, tu peux lui donner des permissions étroites. Le travailleur de recherche lit le CRM. Seule l'étape finale y écrit. Quand quelque chose tourne mal, le rayon de souffle est un rôle, pas tout ton pipeline.
Le prix de cette flexibilité est la coordination. Chaque main à main est un lieu où l'information se perd ou se brouille.
Comment un système multi-agents fonctionne-t-il réellement ?
La plupart des setups production utilisent l'un des trois patterns. Choisis selon la forme de ta tâche, pas selon ce qui semble avancé.
Orchestrateur et travailleurs. Un agent lead lit la demande, planifie, génère les travailleurs et fusionne leurs outputs. Le lead décide des sous-tâches à l'exécution, selon ce qu'il trouve. Ça convient à la recherche et à la préparation ouverte.
Pipeline. Les agents tournent dans un ordre fixe : l'output de l'agent A est l'input de l'agent B. Pas de coordinateur nécessaire. Ça convient au travail que tu pourrais déjà écrire comme une procédure d'exploitation standard (SOP), comme enrichir, scorer, rédiger.
Boucle de révision. Un agent produit, un autre critique contre une checklist, et le premier révise. Ça convient à tout ce où les portes qualité importent plus que la vitesse, comme la copy outbound ou les résumés de contrats.
Anthropoc a publié l'écriture la plus détaillée du public du premier pattern. Dans son post système de recherche multi-agents, un lead Claude Opus 4 avec des subagents Claude Sonnet 4 a surpassé un agent Claude Opus 4 unique de 90,2% sur l'évaluation de recherche interne d'Anthropic. Lis ce chiffre comme un résultat pour la recherche ouverte, pas une promesse pour ton nettoyage CRM.
Étape 1 : Rédige le brief de délégation avant tout
L'échec le plus courant est une main à main vague. « Recherche ce compte » envoyé à trois travailleurs produit trois réponses qui se chevauchent et un parcours gaspillé.
Donne à chaque travailleur quatre choses. Un objectif, un format d'output, les outils et sources qu'il peut utiliser, et une règle d'arrêt. C'est tout le contrat.
Voici un brief pour un travailleur de recherche de prospect :
Objectif : lister les trois signaux de financement ou embauche les plus récents pour un seul compte.
Format : un tableau avec signal, date, URL source.
Outils : recherche web et le seul enregistrement CRM.
Arrêt : après cinq sources ou dix minutes, selon ce qui vient en premier.
Rédige le brief une fois, sauvegarde-le comme une commande, et réutilise-le. Dans CommanderGPT ça signifie une slash command /research avec le brief intégré, donc personne ne le retape. HQ rules : une commande par rôle travailleur, pas de prompts ad hoc.
À quoi ressemble un workflow multi-agents pour une équipe GTM ?
Prends la préparation pré-appel pour un account executive. Un agent unique le fait en un seul long passage et se trompe généralement sur le dernier tiers, parce que l'output d'outil antérieur foule le contexte.
La version fractionnée fonctionne comme ça :
/researchtire les signaux de financement, embauche et news./score-icpcompare le compte à tes critères ICP et renvoie un score d'adéquation avec raisons./draft-emailrédige le message de premier contact à partir des deux outputs structurés.Un agent de révision contrôle le brouillon contre ta liste de phrases interdites et règles de ton.
Remarque ce que le fractionnement te gagne. Si l'email semble off, tu ouvres l'input de l'étape 3 et vois exactement quel signal l'a alimenté. Avec un agent long unique, tu relis la transcription entière et tu devines.
Les étapes 1 et 2 peuvent tourner en parallèle quand le score ne dépend pas de la recherche. L'étape 3 attend les deux. C'est un petit système multi-agents : trois travailleurs, un revieweur, une règle de main à main.
Si tu le fais tourner dans un workflow enchaîné, attends qu'il prenne plus de temps qu'un seul prompt. Mesure-le dans ta propre stack avant de promettre à quelqu'un un chiffre. Le gain n'est pas la vitesse brute. C'est que l'output de chaque étape est inspectable.
Où ça vaut mieux qu'un agent unique, et où ça perd ?
Le multi-agent mérite son investissement sur le travail qui se divise proprement. La recherche sur plusieurs sources, la préparation sur plusieurs comptes et les audits sur plusieurs documents se qualifient tous. Les travailleurs tournent côte à côte et le lead coud les résultats.
Ça perd sur le travail étroitement couplé. Quand l'étape 4 dépend de chaque détail des étapes 1 à 3, les fractionner te force à presser tout ce détail dans un résumé. Anthropic fait le même point sur son propre système : la plupart des tâches de code ont moins de morceaux vraiment parallélisables que la recherche, et les agents ne sont pas encore doués pour coordonner et déléguer les uns aux autres en temps réel.
Oublie le multi-agent si l'une de ces choses est vraie :
La tâche rentre confortablement en une fenêtre de contexte.
Chaque étape a besoin du détail complet de la précédente.
Tu ne peux pas décrire les rôles des travailleurs en une phrase chacun.
Le travail tourne quelques fois par mois. Le temps d'installation ne rapporte jamais.
Ça vaut la peine de bâtir si la tâche est parallèle, les rôles sont distincts et tu la fais tourner quotidiennement.
Combien coûte un système multi-agents ?
Des tokens, surtout. Anthropic rapporte que les agents utilisent environ 4 fois plus de tokens que le chat, et les systèmes multi-agents environ 15 fois plus. Ces chiffres viennent de leur charge de travail de recherche, donc traite-les comme un ordre de grandeur, pas une citation pour ta facture.
La règle pratique : fais tourner les chiffres sur une tâche réelle avant de le mettre à l'échelle. Compte les tokens par parcours, multiplie par les parcours par semaine, compare aux minutes économisées. Si un workflow prep économise 20 minutes et coûte quelques dollars d'utilisation de modèle, c'est généralement un bon commerce. Si ça économise 2 minutes et coûte pareil, ce ne l'est pas.
La latence est le deuxième coût. Chaque décision de coordinateur ajoute un aller-retour. Limite le nombre de travailleurs, limite les réessais et définis un timeout dur.
Quels outils te laissent en bâtir un sans coder ?
Tu as trois routes réalistes en 2026.
Constructeurs d'agents. Les outils sans code te laissent définir les agents et les mains à main visuellement. Ils conviennent aux workflows métier récurrents et aux petites équipes.
Chaînage basé sur commandes. Les slash commands et les chaînes de workflow conviennent aux équipes qui veulent des étapes réutilisables et inspectables dans Slack ou une palette de commandes. Raycast couvre le côté lanceur, et CommanderGPT ajoute le chaînage et les Team Playbooks partagés par-dessus.
Frameworks de code. Si ton équipe a des ingénieurs, les frameworks donnent le contrôle complet de l'orchestration, au prix de la maintenance. Les équipes ops sans cette capacité doivent commencer avec les deux premières routes.
Quelle que soit la route que tu choisis, enregistre chaque main à main. Quand l'output final est mauvais, tu dois voir quel travailleur a produit le mauvais input.
Qu'est-ce qui se casse en premier dans un système multi-agents ?
Trois choses, dans cet ordre.
Outputs partiels silencieux. Un travailleur explose et ne renvoie rien, et le lead écrit la réponse finale de toute façon. Corrige-le en demandant à chaque travailleur de renvoyer un statut explicite : fait, partiel ou échoué.
Travail dupliqué. Deux travailleurs obtiennent des briefs qui se chevauchent et brûlent les tokens sur les mêmes sources. Corrige-le avec des limites de tâche plus serrées dans le brief.
Dérive sur chaînes longues. Chaque main à main perd un peu de détail. À l'étape cinq l'objectif original est flou. Corrige-le en passant la demande originale à chaque travailleur, pas seulement l'output précédent.
Teste les cas de défaillance à dessein pendant l'installation. Tue un outil, renvoie un résultat vide et vois ce que le lead fait. C'est mieux de le découvrir mardi après-midi qu'en face d'un client.
Ta prochaine commande : commence avec deux agents, pas sept
Choisis un workflow que tu exécutes déjà à la main chaque semaine. Divise-le en deux rôles au maximum : un producteur et un vérificateur. Rédige un brief de quatre lignes pour chacun. Fais-le tourner dix fois et enregistre ce qui se casse.
Ajoute seulement un troisième agent quand la version à deux agents montre un goulot d'étranglement clair. La plupart des workflows ops cessent de rapporter quelque part entre deux et quatre agents.
Mission terminée quand le parcours à deux agents surpasse ta version manuelle en minutes économisées et taux d'erreur. Jusqu'à là, rien d'autre dans ce guide ne compte.