O que é um sistema multiagente? Guia prático de ops
Resumo
Um sistema multiagente é um grupo de agentes de IA que dividem um trabalho: cada especialista recebe seu próprio papel, ferramentas e contexto, coordenados por um agente líder ou ordem fixa de hand-off. Vence um único agente em trabalho que se divide limpo, como pesquisa ou prep de conta, e perde em tarefas fortemente acopladas. Espere custo de token mais alto e latência, então comece com dois agentes.
O que é um sistema multiagente? É um conjunto de agentes de IA que dividem um trabalho entre eles, cada um com seu próprio papel, ferramentas e contexto, coordenados por um agente líder ou uma ordem fixa de passagem de responsabilidade. Se você já usa um agente único e constantemente bata contra seus limites, essa é a próxima arquitetura para entender. Abaixo: como funciona em uma stack de ops e quando custa mais do que retorna.
Briefing 30 segundos: um agente faz tudo em um contexto longo. Um sistema multiagente dá cada etapa a um especialista e adiciona um coordenador. Você ganha trabalho paralelo e outputs mais limpos. Paga em tokens, latência e tempo de debug.
O que é um sistema multiagente, em termos práticos de ops?
Pense em como seu time executa uma revisão de deal. Uma pessoa puxa dados de conta. Outra valida o fit contra seu perfil ideal de cliente (ICP). Uma terceira escreve o follow-up. Um líder lê os três outputs e decide o que vai. Um sistema multiagente replica essa estrutura em software. Cada agente é uma chamada de modelo com instrução estreita, suas próprias ferramentas e sua própria memória de trabalho. Um coordenador divide a tarefa, envia as peças e mescla os resultados.
Considere um caso concreto. Um líder de customer success quer um resumo de saúde semanal para 40 contas. Um agente lendo 40 históricos de suporte, 40 exports de uso e 40 notas de renovação vai perder o fio por volta da conta 15. Quarenta pequenos workers, cada um lendo uma conta, depois um líder ranqueando os resultados, não. Essa é a ideia central: quebra um trabalho amplo em trabalhos estreitos, depois remonta.
Dois traços importam. Primeiro, cada agente carrega apenas o que precisa, então seu contexto fica pequeno e focado. Segundo, agentes trocam outputs estruturados, não chat livre. Pule qualquer um dos dois e você tem um thread barulhento de grupo, não um sistema.
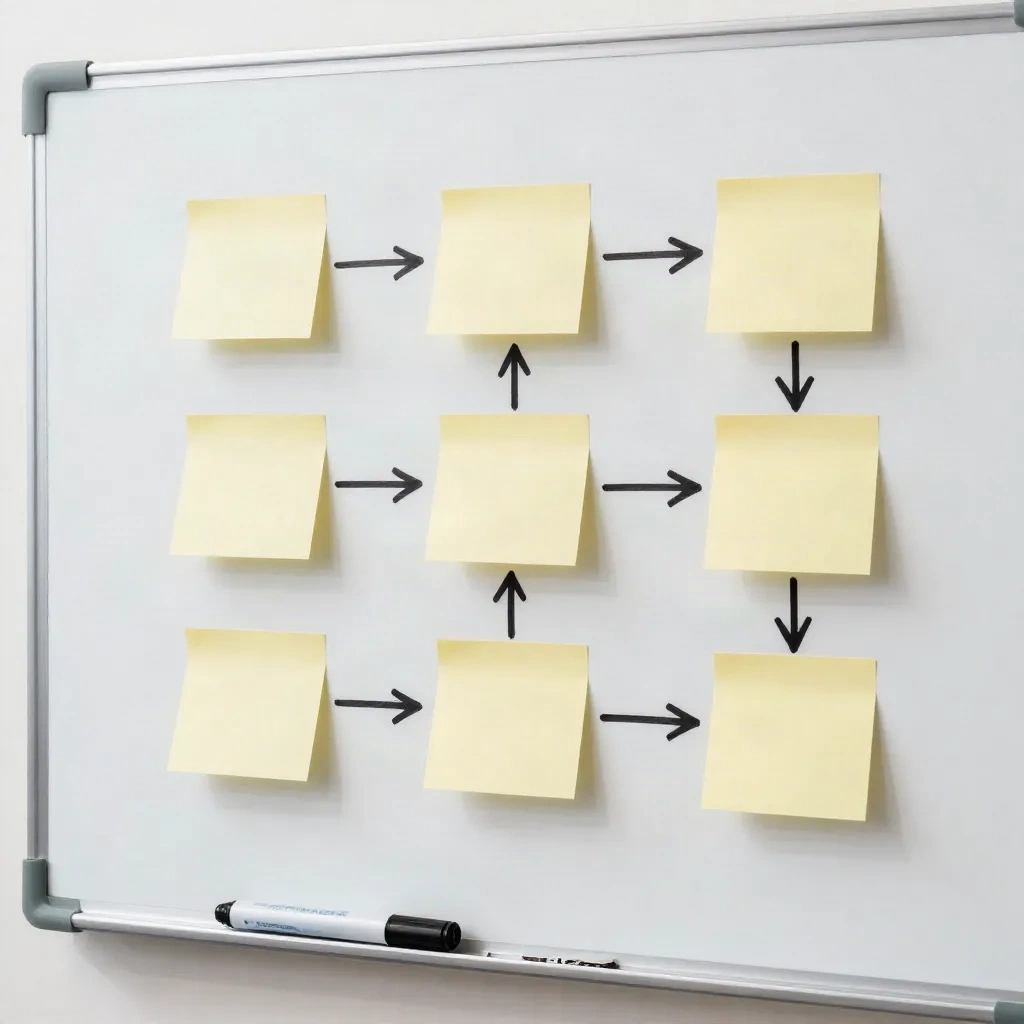
Como é diferente de um agente único ou um chatbot?
Um chatbot responde um prompt. Um agente único persegue um objetivo através de várias etapas, chamando ferramentas pelo caminho. Cobrimos essa lacuna em nosso breakdown agente vs chatbot de ops.
Um sistema multiagente adiciona uma terceira camada: vários agentes, cada um dono de um pedaço do objetivo. A diferença aparece em três lugares.
Contexto. Um agente único arrasta cada resultado de ferramenta através de uma janela. Especialistas cada um veem apenas seu pedaço.
Paralelismo. Um agente trabalha em sequência. Um líder pode lançar cinco workers ao mesmo tempo.
Modo de falha. Um agente falha como um todo. Em um sistema, um worker falha e o líder pode refazer apenas aquele pedaço.
Há também uma vantagem de governança que times de ops tendem a subestimar. Porque cada worker tem um papel estreito, você pode dar permissões estreitas. O worker de pesquisa lê o CRM. Apenas o passo final escreve nele. Quando algo dá errado, o raio de explosão é um papel, não seu pipeline inteiro.
O custo dessa flexibilidade é coordenação. Cada passagem é um lugar onde informação pode ser perdida ou deformada.
Como um sistema multiagente realmente funciona?
A maioria dos setups de produção usa um de três padrões. Escolha pela forma da sua tarefa, não por o que soa avançado.
Orquestrador e workers. Um agente líder lê a requisição, planeja, spawna workers e mescla seus outputs. O líder decide as subtarefas em runtime, baseado no que encontra. Isso se encaixa em pesquisa e prep aberto.
Pipeline. Agentes rodam em ordem fixa: o output do agente A é input do agente B. Sem coordenador necessário. Isso se encaixa em trabalho que você já poderia escrever como um procedimento operacional padrão (SOP), como enriquecer, pontuar, rascunhar.
Review loop. Um agente produz, outro critica contra uma checklist, e o primeiro revisa. Isso se encaixa em qualquer coisa onde gates de qualidade importam mais que velocidade, como copy de saída ou resumos de contrato.
A Anthropic publicou o write-up público mais detalhado do primeiro padrão. Em seu post de sistema multiagente de pesquisa, um Claude Opus 4 líder com Claude Sonnet 4 subagentes superou um agente Claude Opus 4 único por 90.2% na avaliação interna de pesquisa da Anthropic. Leia aquele número como um resultado para pesquisa aberta, não uma promessa para seu cleanup de CRM.
Passo 1: Escreva o briefing de delegação antes de qualquer coisa
A falha mais comum é um hand-off vago. "Pesquise essa conta" enviado para três workers produz três respostas sobrepostas e uma execução desperdiçada.
Dê cada worker quatro coisas. Um objetivo, um formato de output, as ferramentas e fontes que pode usar, e uma regra de parada. Esse é o contrato inteiro.
Aqui está um briefing para um worker de pesquisa de prospect:
Objetivo: listar os três sinais mais recentes de financiamento ou contratação para uma conta.
Formato: uma tabela com sinal, data, URL de fonte.
Ferramentas: pesquisa na web e o registro do CRM apenas.
Parada: após cinco fontes ou dez minutos, o que vier primeiro.
Escreva o briefing uma vez, salve como um comando e reutilize. No CommanderGPT isso significa um comando slash /research com o briefing cozido, então ninguém retipa. Regras HQ: um comando por papel de worker, sem prompts ad hoc.
Como é um workflow multiagente para um time de GTM?
Pegue prep pré-call para um account executive. Um agente único faz em um passe longo e normalmente erra o último terço, porque o output de ferramenta inicial superlota o contexto.
A versão dividida roda assim:
/researchpuxa sinais de financiamento, contratação e notícias./score-icpcompara a conta contra seus critérios de ICP e retorna um score de fit com razões./draft-emailescreve a mensagem de first-touch dos dois outputs estruturados.Um agente de review valida o draft contra sua lista de frases banidas e regras de tom.
Note o que a divisão compra. Se o email soa estranho, você abre o input do passo 3 e vê exatamente qual sinal o alimentou. Com um agente longo único, você relê o transcrito inteiro e adivinha.
Os passos 1 e 2 podem rodar em paralelo quando o score não depende da pesquisa. Passo 3 espera ambos. Esse é um pequeno sistema multiagente: três workers, um revisor, uma regra de hand-off.
Se você rodar isso em um workflow encadeado, espere que demore mais que um prompt único. Meça em sua própria stack antes de prometer a alguém um número. O ganho não é velocidade bruta. É que o output de cada passo é inspecionável.
Onde multiagente vence, e onde perde?
Multiagente ganha com trabalho que se divide limpo. Pesquisa através de muitas fontes, prep através de muitas contas, e audits através de muitos documentos qualificam. Workers rodam lado a lado e o líder amarra os resultados.
Perde em trabalho fortemente acoplado. Quando passo 4 depende de cada detalhe dos passos 1 a 3, dividi-los o força a espremer detalhe através de um resumo. A Anthropic faz o mesmo ponto sobre seu próprio sistema: a maioria das tarefas de coding tem menos pedaços verdadeiramente paralizáveis que pesquisa, e agentes ainda não são ótimos em coordenar e delegar um para o outro em tempo real.
Pule multiagente se qualquer um disso for verdadeiro:
A tarefa cabe confortavelmente em uma janela de contexto.
Cada passo precisa do detalhe completo do anterior.
Você não consegue descrever os papéis dos workers em uma frase cada.
O trabalho roda algumas vezes por mês. O tempo de setup nunca paga.
Vale a pena construir se a tarefa é paralela, os papéis são distintos e você roda diariamente.
Quanto custa um sistema multiagente?
Tokens, principalmente. A Anthropic relata que agentes usam cerca de 4 vezes mais tokens que chat, e sistemas multiagentes cerca de 15 vezes mais. Esses números vêm de sua carga de trabalho de pesquisa, então trate como uma ordem de magnitude, não uma citação para sua conta.
A regra prática: rode os números em uma tarefa real antes de escalar. Conte tokens por execução, multiplique por execuções por semana, compare com minutos economizados. Se um workflow de prep economiza 20 minutos e custa alguns dólares de uso de modelo, isso normalmente é um trade bom. Se economiza 2 minutos e custa o mesmo, não é.
Latência é o segundo custo. Cada decisão de coordenador adiciona um round trip. Limpe o número de workers, limite retries e defina um timeout rígido.
Quais ferramentas deixam você construir uma sem código?
Você tem três rotas realistas em 2026.
Agent builders. Ferramentas sem-código deixam você definir agentes e hand-offs visualmente. Elas se encaixam em workflows de negócio recorrentes e times pequenos.
Chaining baseado em comando. Comandos slash e cadeias de workflow se encaixam em times que querem passos reutilizáveis, inspecionáveis dentro do Slack ou uma paleta de comando. Raycast cobre o lado do lançador, e CommanderGPT adiciona encadeamento e Team Playbooks compartilhados em cima.
Code frameworks. Se seu time tem engenheiros, frameworks dão controle completo sobre orquestração, ao preço de manutenção. Times de ops sem essa capacidade devem começar com as duas primeiras rotas.
Qualquer rota que escolher, registre cada hand-off. Quando o output final está errado, você precisa ver qual worker produziu o input ruim.
O que quebra primeiro em um sistema multiagente?
Três coisas, nessa ordem.
Outputs parciais silenciosos. Um worker esgota tempo e retorna nada, e o líder escreve a resposta final mesmo assim. Corrija exigindo que cada worker retorne um status explícito: pronto, parcial ou falhado.
Trabalho duplicado. Dois workers recebem briefings sobrepostos e queimam tokens nas mesmas fontes. Corrija com limites de tarefa mais apertados no briefing.
Drift em cadeias longas. Cada hand-off perde um pouco de detalhe. Por passo cinco o objetivo original está borrão. Corrija passando a requisição original para cada worker, não apenas o output anterior.
Teste os casos de falha de propósito durante setup. Mate uma ferramenta, retorne um resultado vazio e veja o que o líder faz. Melhor descobrir numa terça à tarde do que na frente de um cliente.
Seu próximo comando: comece com dois agentes, não sete
Pegue um workflow que você já roda à mão toda semana. Divida em dois papéis no máximo: um produtor e um verificador. Escreva um briefing de quatro linhas para cada. Rode dez vezes e registre o que quebra.
Apenas adicione um terceiro agente quando a versão de dois agentes mostrar um gargalo claro. A maioria dos workflows de ops para de pagar de volta em algum lugar entre dois e quatro agentes.
Missão terminada quando a execução de dois agentes bate sua versão manual em minutos economizados e taxa de erro. Até lá, nada mais neste guia importa.